Sitemap w robots.txt: co trzeci polski plik go pomija
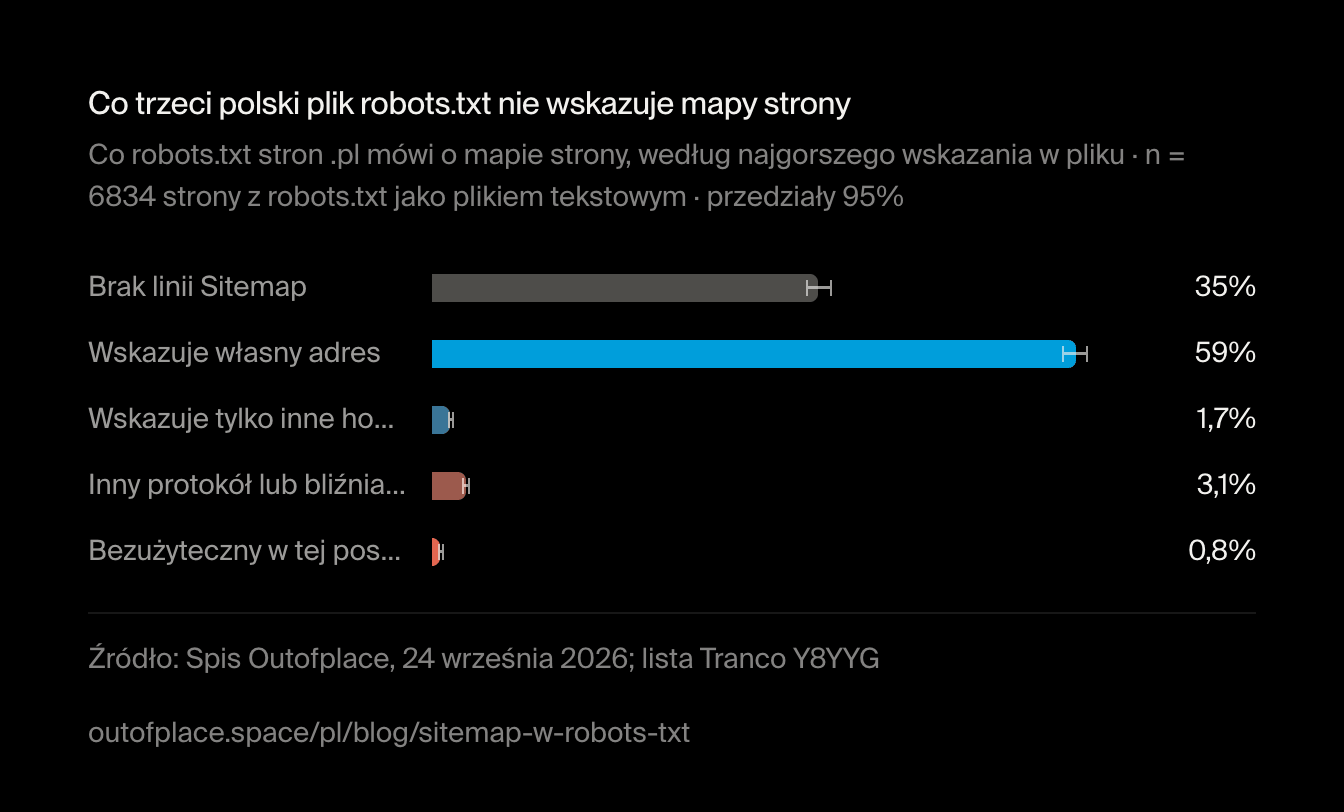
35% z 6834 polskich stron z plikiem robots.txt nie wskazuje w nim mapy strony, a 6% wskazujących podaje zły adres: http, bliźniaka z www lub ścieżkę względną.

Co trzeci polski plik robots.txt nie wskazuje mapy strony (sitemap). Przeczytaliśmy pliki robots.txt 6834 stron .pl z listy Tranco popularnych witryn (otwiera się w nowej karcie), które taki plik mają, i 35% nie ma w nim linii Sitemap:. Spośród tych, które ją mają, 6% wskazuje adres, pod którym strona w tej postaci nie działa: http na stronie z https, bliźniaka z www zamiast prawdziwego hosta, ścieżkę względną, serwer testowy.
Ta linia to jedyne miejsce, w którym każdy crawler, nie tylko Google, dowiaduje się, gdzie leży lista stron witryny. Bez niej crawlery muszą zgadywać, a zgadywanie często zawodzi: na największych polskich stronach bez linii Sitemap: pod adresem /sitemap.xml mapa strony była tylko w 34% przypadków. To, czy linia jest, idzie w parze z platformą strony, a błędne wskazania są częstsze tam, gdzie nie rozpoznaliśmy żadnej platformy, niż tam, gdzie ją rozpoznaliśmy. W naszym badaniu botów AI na polskich stronach mapa strony podana tam, gdzie szukają jej crawlery, była jedną z podstaw, w których polskie strony zostają w tyle; tu jest pełny spis.
- 6834
- 35%
- 6%
- 34%
Co robi linia Sitemap w robots.txt
Mapa strony (sitemap) to plik, zwykle XML, z listą stron, które witryna chce dać do przeszukania crawlerom, opisany w protokole sitemaps.org (otwiera się w nowej karcie). Crawler może się o niej dowiedzieć na dwa sposoby: właściciel zgłasza ją w konsoli wyszukiwarki (Google Search Console, Bing Webmaster Tools), co dociera do tej jednej wyszukiwarki, albo witryna podaje ją w robots.txt, który każdy crawler czyta jako pierwszy.
RFC 9309 (otwiera się w nowej karcie), standard robots.txt, tej linii nie definiuje: wymienia Sitemaps jako przykład „innych rekordów”, które crawlery mogą czytać, i zastrzega, że taki rekord nie może kończyć grupy User-agent. Zasady pochodzą skądinąd:
- sitemaps.org: linia zawiera pełny adres URL mapy strony, a plik może ich wskazać więcej niż jedną. Adresy w mapie muszą mieć jej protokół i host, chyba że robots.txt innego hosta wskazuje na nią (zgłoszenie między hostami).
- Dokumentacja robots.txt Google (otwiera się w nowej karcie) (ostatnia aktualizacja 31 sierpnia 2026): adres musi być pełnym URL-em, z protokołem i hostem, nie musi leżeć na tym samym hoście co robots.txt, a liczba linii jest dowolna. Linia nie jest przypisana do żadnego konkretnego user agenta.
Poprawna linia wygląda więc tak i może stać w dowolnym miejscu pliku:
User-agent: *
Disallow: /koszyk/

Sitemap: https://www.example.pl/sitemap.xml
Co trzecia polska strona nie wskazuje mapy strony
Z 7785 stron, których strona główna odpowiedziała w naszym spisie, 951 nie udostępnia robots.txt jako pliku tekstowego (większość odpowiada błędem 4xx, część stroną HTML); pomijamy je. Wśród pozostałych większość wskazuje mapę strony pod własnym adresem. Druga co do wielkości grupa nie wskazuje żadnej, a grupy wskazujące błędnie są małe, ale nie rzadkie.
Co trzeci polski plik robots.txt nie wskazuje mapy strony
Co robots.txt stron .pl mówi o mapie strony, według najgorszego wskazania w pliku · n = 6834 strony z robots.txt jako plikiem tekstowym · przedziały 95%
Pokaż dane
| Pozycja | Wartość | Przedział 95% | n |
|---|---|---|---|
| Brak linii Sitemap | 35% | 34%–37% | 6834 |
| Wskazuje własny adres | 59% | 58%–60% | 6834 |
| Wskazuje tylko inne hosty | 1,7% | 1,4%–2% | 6834 |
| Inny protokół lub bliźniak z www | 3,1% | 2,7%–3,5% | 6834 |
| Bezużyteczny w tej postaci | 0,8% | 0,6%–1,1% | 6834 |
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Wielkość nie pomaga. Wśród stron z pierwszego tysiąca próby mapę wskazuje 59%, mniej niż 65% stron z dalszych miejsc. Różnica idzie w parze z mieszanką oprogramowania. 74% stron z czołówki nie działa na niczym, co rozpoznajemy jako platformę sklepową, wtyczkę SEO czy WordPressa, wobec 45% stron z dalszych miejsc. Porównując rodzaj z rodzajem, czołówka i reszta wskazują mapę mniej więcej równie często: 52% wobec 55% tam, gdzie nie rozpoznaliśmy niczego, i 76% wobec 74% tam, gdzie rozpoznaliśmy.
Czy sitemap powinien być w robots.txt?
Nie musi: wyszukiwarka znajdzie strony po linkach, a Google i Bing przyjmują mapę zgłoszoną w swoich konsolach. Konsola dociera jednak do jednej wyszukiwarki, a każdy inny crawler (Bing w przypadku strony zgłoszonej tylko w konsoli Google, boty AI, narzędzia SEO) ma linię w robots.txt albo zgadywanie.
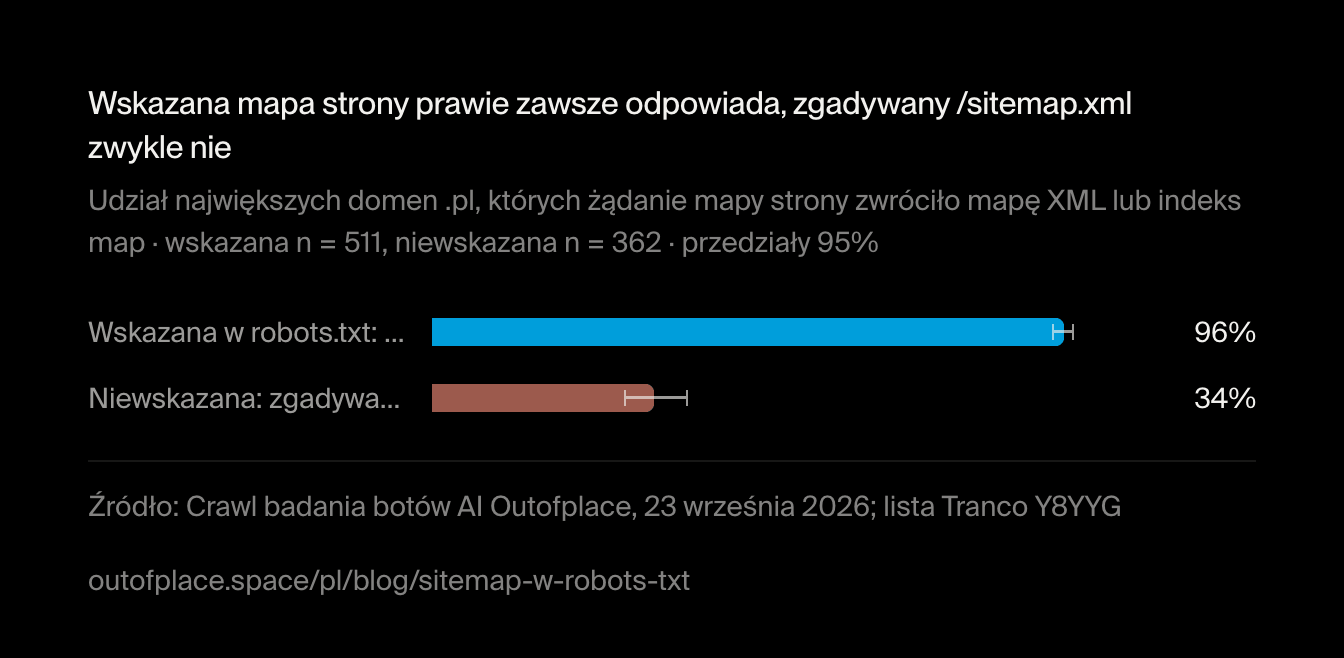
Badanie botów AI pobrało 23 września po jednej mapie strony z każdej z 1000 największych domen .pl: pierwszy adres z Sitemap:, gdy robots.txt go podaje, a w przeciwnym razie /sitemap.xml, przyjęty domyślnie adres. Oba wyniki pokazują, co crawler znajduje z linią i bez niej.
Wskazana mapa strony prawie zawsze odpowiada, zgadywany /sitemap.xml zwykle nie
Udział największych domen .pl, których żądanie mapy strony zwróciło mapę XML lub indeks map · wskazana n = 511, niewskazana n = 362 · przedziały 95%
Pokaż dane
| Pozycja | Wartość | Przedział 95% | n |
|---|---|---|---|
| Wskazana w robots.txt: pierwszy URL z Sitemap | 96% | 95%–98% | 511 |
| Niewskazana: zgadywany /sitemap.xml | 34% | 29%–39% | 362 |
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Mapą strony odpowiedziało 96% wskazanych adresów. Bez linii /sitemap.xml zadziałał w 34% przypadków; reszta odpowiadała przeważnie błędem, część stroną HTML. Te strony mogą mieć mapę gdzie indziej, zgłoszoną w Google, ale crawler, który czyta tylko robots.txt, nie ma jak się o niej dowiedzieć.
Kto pisze linię Sitemap: platforma albo nikt
CMS albo platforma sklepowa może sama serwować robots.txt, a wtedy to, czy plik wskazuje mapę strony, zależy od ustawień platformy. WordPress 5.5 (otwiera się w nowej karcie) (2020) sprawił, że jego robots.txt wskazuje indeks map pod /wp-sitemap.xml; wtyczki SEO zastępują go własnym.
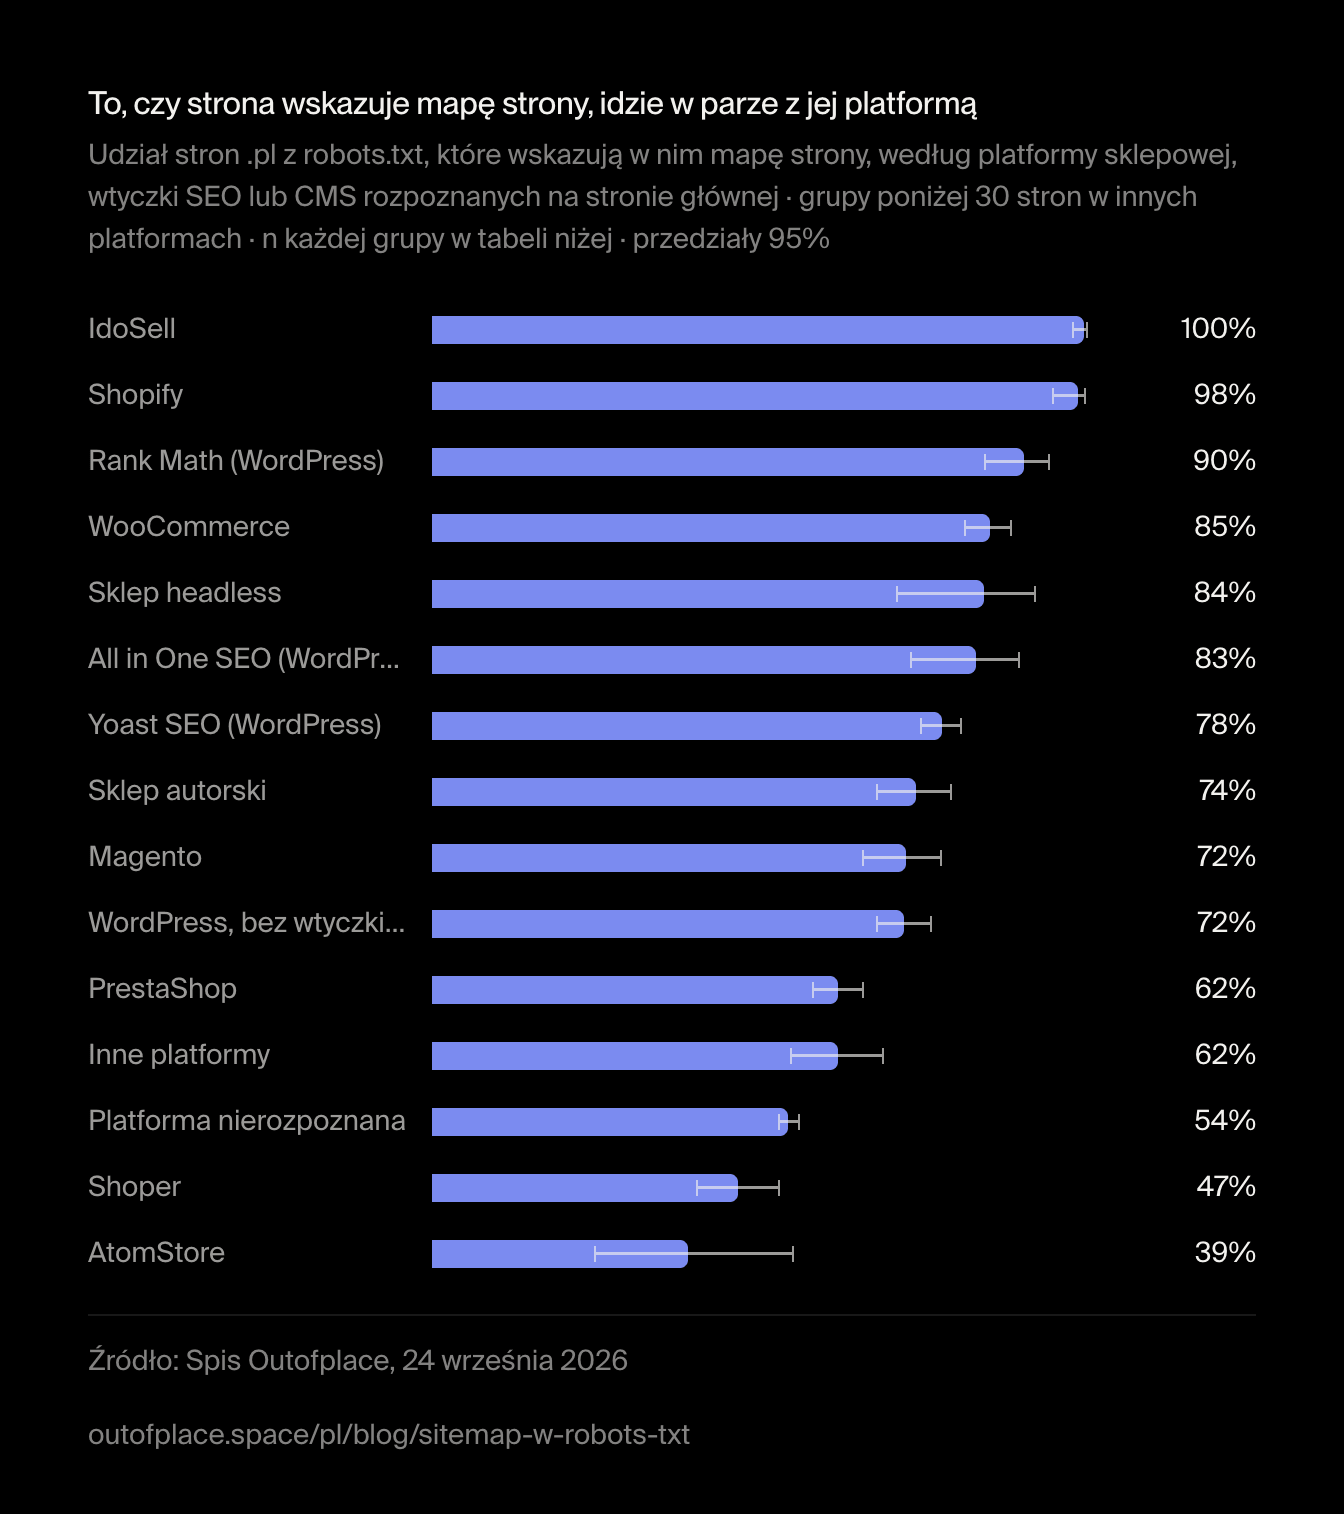
To, czy strona wskazuje mapę strony, idzie w parze z jej platformą
Udział stron .pl z robots.txt, które wskazują w nim mapę strony, według platformy sklepowej, wtyczki SEO lub CMS rozpoznanych na stronie głównej · grupy poniżej 30 stron w innych platformach · n każdej grupy w tabeli niżej · przedziały 95%
Pokaż dane
| Pozycja | Wartość | Przedział 95% | n |
|---|---|---|---|
| IdoSell | 100% | 97%–100% | 217 |
| Shopify | 98% | 94%–100% | 127 |
| Rank Math (WordPress) | 90% | 84%–94% | 135 |
| WooCommerce | 85% | 81%–88% | 381 |
| Sklep headless | 84% | 71%–92% | 44 |
| All in One SEO (WordPress) | 83% | 73%–90% | 76 |
| Yoast SEO (WordPress) | 78% | 74%–81% | 662 |
| Sklep autorski | 74% | 68%–79% | 214 |
| Magento | 72% | 66%–78% | 201 |
| WordPress, bez wtyczki SEO | 72% | 68%–76% | 437 |
| PrestaShop | 62% | 58%–66% | 553 |
| Inne platformy | 62% | 54%–69% | 173 |
| Platforma nierozpoznana | 54% | 53%–56% | 3351 |
| Shoper | 47% | 40%–53% | 227 |
| AtomStore | 39% | 25%–55% | 36 |
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Platformy sklepowe w abonamencie są na obu końcach. Na IdoSell i Shopify mapę wskazuje prawie każdy sklep. Na Shoperze i AtomStore robi to około połowy sklepów z naszej próby lub mniej, a obu platform nie da się od siebie odróżnić (AtomStore to mała grupa 36 sklepów). Z samego robots.txt nie wiemy, czy to skutek ustawienia platformy, opcji każdego sklepu czy plików, które sklepy edytują same. WordPress z wtyczką SEO jest wysoko, a największa grupa, strony, na których nie rozpoznaliśmy żadnej platformy, jest blisko dołu z wynikiem 54%.
Na platformy wskazują też nazwy plików. Najczęstsza jest sitemap.xml, na 45% stron ze wskazaniem własnego hosta, a niektóre z kolejnych nazw należą prawie wyłącznie do jednego rodzaju oprogramowania, jak 1_index_sitemap.xml do PrestaShop i googlesitemap do Shopera:
| Nazwa pliku | Największa grupa wskazujących ją stron | Strony | Udział |
|---|---|---|---|
| sitemap.xml | Platforma nierozpoznana (63%) | 1892 | 45% |
| sitemap_index.xml | Yoast SEO (WordPress) (47%) | 942 | 22% |
| sitemap.xml.gz | IdoSell (89%) | 242 | 5,7% |
| 1_index_sitemap.xml | PrestaShop (98%) | 235 | 5,5% |
| wp-sitemap.xml | WordPress, bez wtyczki SEO (76%) | 222 | 5,2% |
| (bez nazwy pliku) | Platforma nierozpoznana (76%) | 86 | 2% |
| googlesitemap | Shoper (100%) | 79 | 1,9% |
| sitemap-index.xml | Platforma nierozpoznana (75%) | 77 | 1,8% |
Jak często wskazanie mapy strony jest błędne?
Każdą wartość Sitemap: przypisaliśmy do rodzaju adresu, porównując ją z adresem, na którym naprawdę wylądowała strona główna. Wskazanie własnego adresu to norma. Wskazanie innego hosta dopuszczają i Google, i sitemaps.org, i samo w sobie nie jest błędem: mapa w CDN, na subdomenie sklepu, na siostrzanej witrynie. Reszta dzieli się na dwie grupy.
- Niezgodne: własny host strony z
httpzamiasthttps(albo z innym portem) lub bliźniak zwwwhosta, na którym ląduje strona główna. Działają tylko wtedy, gdy serwer przekierowuje, a według zasady sitemaps.org mapa pobrana zhttp://mówi o adresachhttp://. - Zepsute: w tej postaci nie dają adresu, którego da się użyć. Ścieżka względna w rodzaju
/sitemap.xml, którą wyklucza wymóg pełnego URL-a w dokumentacji Google; host bezhttps://;localhost, domena.testalbo hostdev.pozostały po wersji testowej; albo szablon, w którym nikt nie wypełnił zmiennej ({page_domain}/…,undefined/…).
Większość błędnych wskazań mapy strony to http lub zły wariant www
Udział stron .pl wskazujących mapę strony z co najmniej jednym wskazaniem danego rodzaju · dozwolone wskazania innych hostów na szaro, niezgodne w jasnym ciepłym, zepsute w ciemnym ciepłym · n = 4411 · przedziały 95%
Pokaż dane
| Pozycja | Wartość | Przedział 95% | n |
|---|---|---|---|
| Inna witryna | 3% | 2,5%–3,5% | 4411 |
| www zamiast domeny bez www, lub odwrotnie | 2,4% | 2%–2,9% | 4411 |
| http zamiast https (lub inny port) | 2,4% | 2%–2,9% | 4411 |
| Ścieżka względna (/sitemap.xml) | 1% | 0,7%–1,3% | 4411 |
| Inny host tej samej witryny | 0,7% | 0,5%–1% | 4411 |
| localhost, .test lub host testowy | 0,1% | 0,1%–0,3% | 4411 |
| Niewypełniony szablon ({page_domain}) | 0,1% | 0%–0,2% | 4411 |
| Bez http(s):// przed hostem | 0,1% | 0%–0,2% | 4411 |
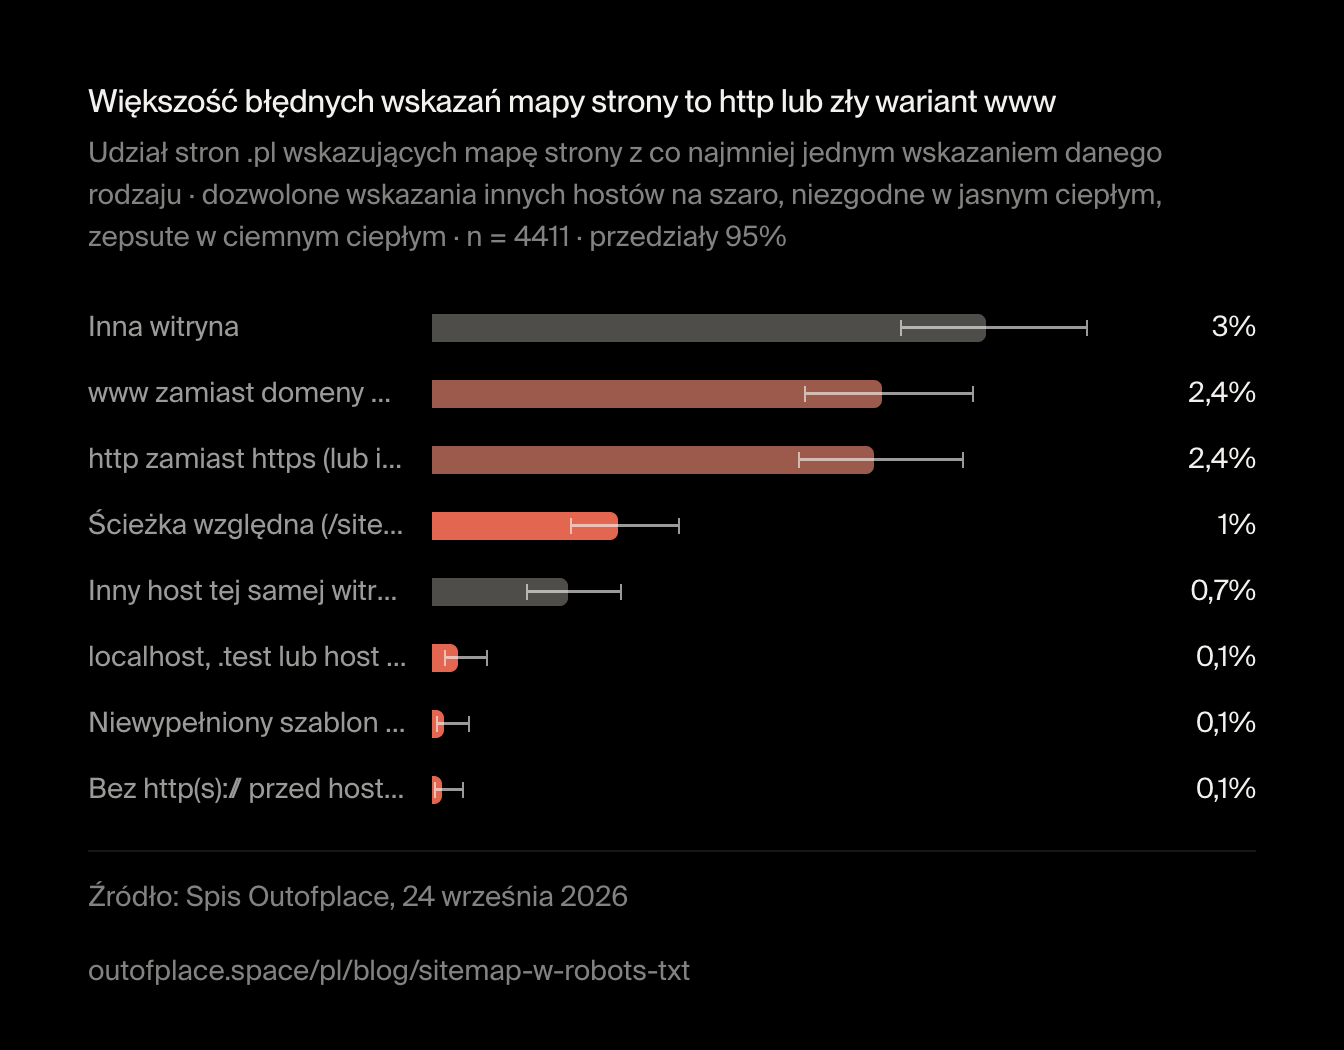
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Razem 266 stron podaje co najmniej jeden zły adres: 211 niezgodny i 55 zepsuty. Nie byłoby to takie ważne, gdyby obok złej linii stała dobra, ale to rzadkość: 247 z tych stron nie wskazuje mapy pod własnym adresem w ogóle, a w 53 przypadkach zepsute jest każde wskazanie.
Błędne wskazania są częstsze tam, gdzie nie rozpoznaliśmy oprogramowania. Tam, gdzie rozpoznaliśmy platformę, wtyczkę albo WordPressa, błędnie wskazuje 4,1% stron z mapą w robots.txt; tam, gdzie nie rozpoznaliśmy niczego, 8,8%.
Kilka map strony w robots.txt
Większość plików wskazuje jedną mapę: tak robi 85% stron, które wskazują jakąkolwiek. Najdłuższy plik, jaki znaleźliśmy, wymienia ich 492. Google nie wyznacza limitu, więc długa lista nie jest błędem, ale to znak, że strona wymienia każdą mapę tam, gdzie wystarczyłby jeden indeks map.
Większość polskich stron wskazuje w robots.txt jedną mapę strony
Liczba linii Sitemap w robots.txt stron .pl, które wskazują co najmniej jedną · n = 4411 · przedziały 95%
Pokaż dane
| Pozycja | Wartość | Przedział 95% | n |
|---|---|---|---|
| 1 linia | 85% | 84%–86% | 4411 |
| 2 linie | 9,1% | 8,2%–9,9% | 4411 |
| 3–5 linii | 3,3% | 2,8%–3,9% | 4411 |
| 6–20 linii | 2% | 1,6%–2,5% | 4411 |
| 21 lub więcej | 0,5% | 0,4%–0,8% | 4411 |
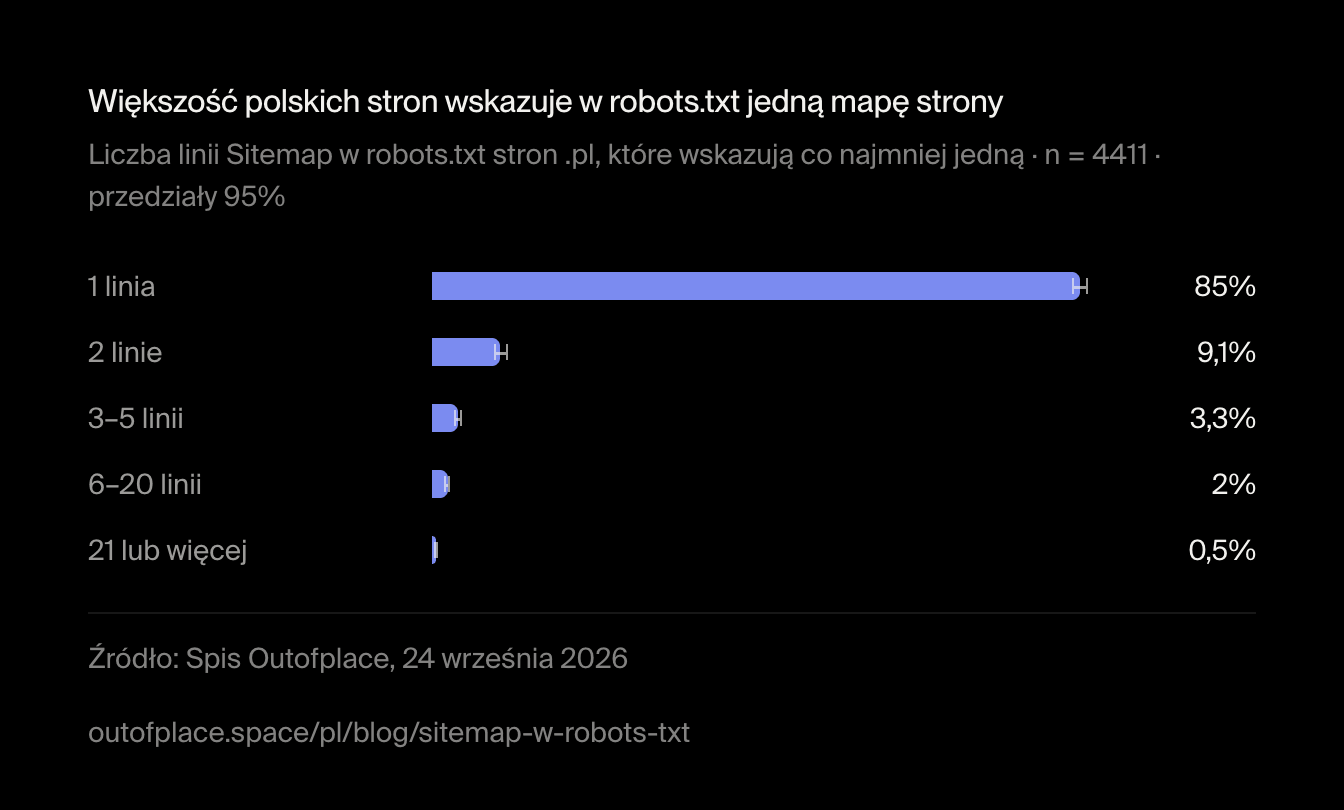
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Powtórzenia są rzadsze: 45 stron wymienia ten sam adres więcej niż raz, w sumie 115 zbędnych linii. Nie szkodzą, a sugerują plik, który rósł przez kopiowanie.
Jak dodać sitemap do robots.txt
Sprawdź, co dziś mówi twój robots.txt
Otwórz
https://twoja-domena/robots.txtw przeglądarce albo w terminalu:curl -s https://www.example.pl/robots.txt | grep -i '^sitemap'Brak linii to częsty przypadek. Jeśli plik pisze twoja platforma, poszukaj ustawienia u niej, zanim zaczniesz cokolwiek edytować ręcznie.
Znajdź prawdziwy adres mapy strony
Otwórz adres, na którym ląduje twoja strona główna, i zapisz jego protokół i host:
https://example.plihttps://www.example.plto dla crawlera dwa różne hosty. Mapa leży zwykle pod/sitemap.xml,/sitemap_index.xml(wtyczki SEO, na przykład Yoast SEO) albo/wp-sitemap.xml(WordPress bez wtyczki); otwórz ją i sprawdź, czy to XML, a nie twoja strona 404.Pisz jeden pełny adres w linii
Dopisz linię w dowolnym miejscu pliku, poza grupą albo w niej: tak czy inaczej dotyczy każdego crawlera.
robots.txt Sitemap: https://www.example.pl/sitemap_index.xmlNie
/sitemap.xml, niewww.example.pl/sitemap.xml, niehttp://na stronie zhttps.Zamiast wielu linii wybierz jeden indeks map
Według protokołu sitemaps.org (otwiera się w nowej karcie) mapa strony mieści do 50 000 adresów i 50 MB po rozpakowaniu; powyżej podziel ją i wymień części w indeksie map, który może wymienić 50 000 map. W robots.txt wskaż indeks. Mapa na innym hoście (CDN, subdomena) jest w porządku, jeśli wskazuje ją twój robots.txt.
Sprawdzaj po każdej migracji
Przejście na
https, dodanie albo usunięciewww, skopiowanie wersji testowej na produkcję: to wtedy wskazania się dezaktualizują. Po przeprowadzce pobierz robots.txt jeszcze raz i otwórz każdy adres zSitemap:.
| Oprogramowanie strony | Strony | Wskazują mapę strony | Z nich błędnie |
|---|---|---|---|
| IdoSell | 217 | 100% | 6% |
| Shopify | 127 | 98% | 0,8% |
| Rank Math (WordPress) | 135 | 90% | 0,8% |
| WooCommerce | 381 | 85% | 1,9% |
| Sklep headless | 44 | 84% | 2,7% |
| All in One SEO (WordPress) | 76 | 83% | 6,4% |
| Yoast SEO (WordPress) | 662 | 78% | 4,7% |
| Sklep autorski | 214 | 74% | 3,8% |
| Magento | 201 | 72% | 2,8% |
| WordPress, bez wtyczki SEO | 437 | 72% | 6% |
| PrestaShop | 553 | 62% | 3,8% |
| Inne platformy | 173 | 62% | 3,7% |
| Platforma nierozpoznana | 3351 | 54% | 8,8% |
| Shoper | 227 | 47% | 9,4% |
| AtomStore | 36 | 39% | 0% |
Jak mierzyliśmy
Czego te dane nie mówią
Czytaliśmy robots.txt w postaci wysłanej przez serwer; map strony ze spisu nie pobieraliśmy, więc poprawne wskazanie pustej albo nieaktualnej mapy liczy się jako poprawne, a niezgodne może równie dobrze przekierowywać do właściwego pliku. Mapa tekstowa (jeden adres w linii, co sitemaps.org dopuszcza) w teście pobrania liczy się jako brak mapy. Strony mogą zgłaszać mapy w Google Search Console albo Bing Webmaster Tools, czego nie widzimy: brak linii nie znaczy, że Google nie zna mapy. Grupy platform zależą od tego, co zdradza strona główna; strona z własnym motywem może trafić do grupy bez platformy.
Czy sitemap powinien być w robots.txt?
Nie musi, ale to jedyne miejsce, do którego zagląda każdy crawler. Mapa strony zgłoszona w Google Search Console albo Bing Webmaster Tools trafia tylko do tej jednej wyszukiwarki. W naszej próbie z września 2026 crawler, który na dużej polskiej stronie bez linii Sitemap zgadywał adres /sitemap.xml, znajdował tam mapę strony w 34% przypadków.
Jak dodać sitemap do robots.txt?
Dopisz w dowolnym miejscu pliku linię z pełnym adresem mapy strony, z protokołem i hostem: Sitemap: https://www.example.pl/sitemap.xml. Użyj adresu, pod którym strona naprawdę działa (https i host z www albo bez, ten, na którym ląduje strona główna). Linia nie należy do żadnej grupy User-agent.
Czy adres sitemap w robots.txt może być względny?
Nie. Dokumentacja robots.txt Google wymaga pełnego adresu URL, z protokołem i hostem, a protokół sitemaps.org też mówi o pełnym adresie. Linia w rodzaju Sitemap: /sitemap.xml nie daje crawlerowi adresu, który musiałby umieć rozwinąć.
Czy robots.txt może wskazywać kilka map strony?
Tak. Google przyjmuje dowolną liczbę linii Sitemap, a protokół sitemaps.org dopuszcza więcej niż jedną w pliku. Przy wielu mapach jeden indeks map strony, który wymienia pozostałe, utrzymuje robots.txt krótkim: według protokołu sitemaps.org indeks może wymienić do 50 000 map.
Czy mapa strony może leżeć w innej domenie?
Tak, jeśli wskazuje ją robots.txt. Google pisze, że adres mapy strony nie musi być na tym samym hoście co robots.txt, a zasada zgłaszania między hostami w sitemaps.org traktuje linię w robots.txt jako dowód, że strona ręczy za mapę trzymaną gdzie indziej, na przykład w CDN.