Boty AI kontra polski internet: robots.txt 1000 stron .pl
Sprawdziliśmy plik robots.txt 1000 największych stron .pl: co piąta blokuje boty AI, głównie treningowe jak GPTBot, rzadko wyszukiwarki AI. Jak to rozdzielić?

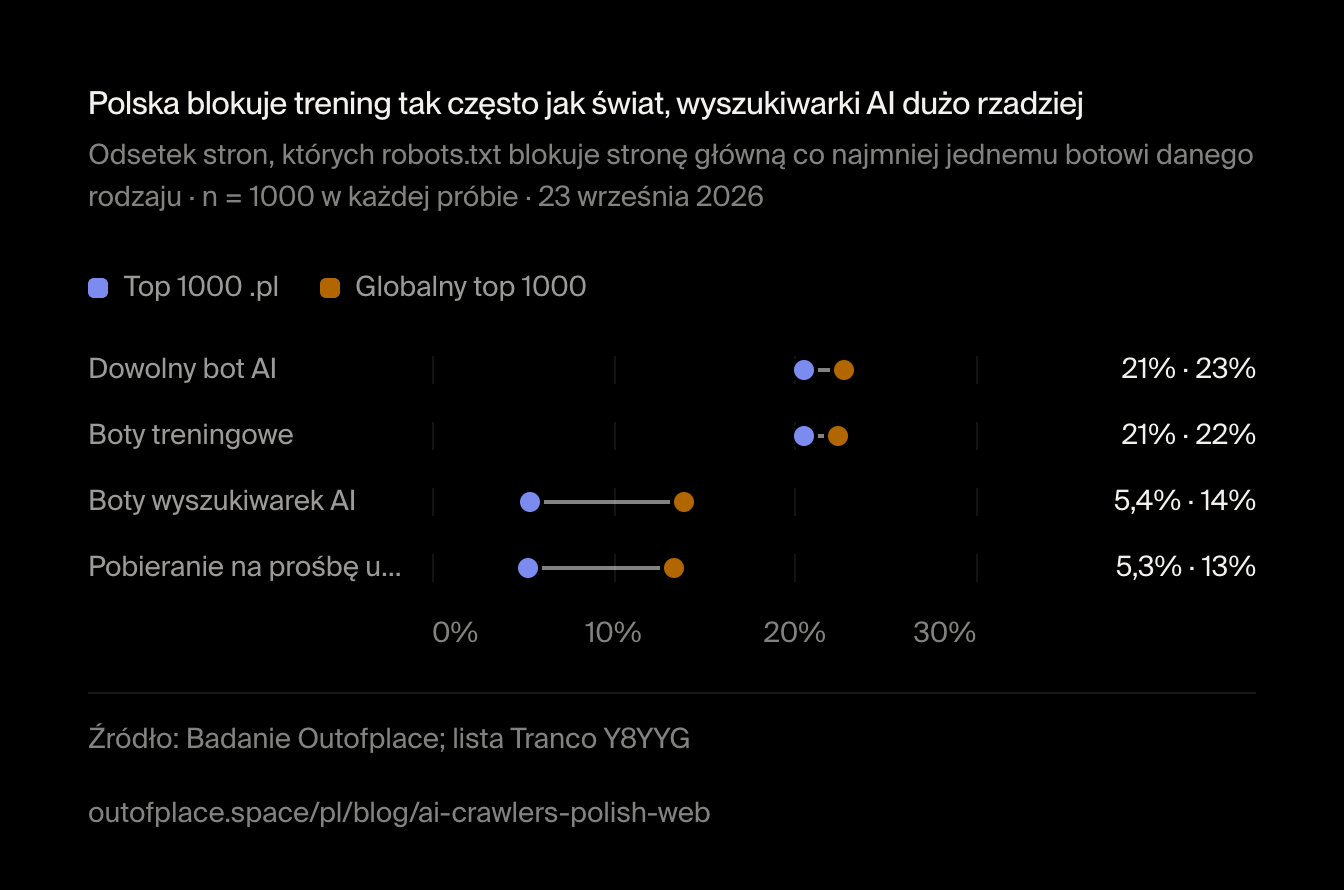
23 września 2026 nasz crawler OutofplaceResearchBot przeczytał plik robots.txt tysiąca najpopularniejszych stron w domenie .pl, żebyśmy mogli sprawdzić, które boty AI wpuszczają. 20,5% z nich blokuje co najmniej jednego bota AI. Statystycznie to tyle samo, co w światowym top 1000, gdzie odsetek wynosi 22,7%.
Różnica leży w tym, których botów to dotyczy. Polskie strony zamykają drzwi przed botami zbierającymi dane treningowe, a wyszukiwarki AI w większości wpuszczają. Bota wyszukiwarki AI blokuje tylko 5,4% z nich, przy 13,9% na świecie. Jeśli chcesz pojawiać się w odpowiedziach ChatGPT, Claude'a czy Perplexity, to właściwa kolejność. Tyle że czasem wychodzi przypadkiem: stara lista skopiowana raz i nigdy nieaktualizowana.
- 20,5%
- 15,1%
- 5,4%
- 9,2%
Boty AI: co to jest i jakie są rodzaje
„Bot AI” to trzy różne zadania i dostawcy dają dziś każdemu osobny user agent. To rozróżnienie decyduje o wszystkim, co dalej:
- Boty treningowe zbierają strony do trenowania modeli: GPTBot (otwiera się w nowej karcie) (OpenAI), ClaudeBot (otwiera się w nowej karcie) (Anthropic), Google-Extended (otwiera się w nowej karcie), Applebot-Extended (otwiera się w nowej karcie), CCBot (otwiera się w nowej karcie) (Common Crawl), Bytespider (ByteDance), meta-externalagent (Meta), Amazonbot (otwiera się w nowej karcie).
- Boty wyszukiwarek AI indeksują strony, żeby asystent mógł je znaleźć i zacytować: OAI-SearchBot, Claude-SearchBot, PerplexityBot (otwiera się w nowej karcie), DuckAssistBot (otwiera się w nowej karcie).
- Boty pobierające na prośbę użytkownika otwierają stronę, bo ktoś poprosił o to asystenta: ChatGPT-User, Claude-User, Perplexity-User, meta-externalfetcher, MistralAI-User (otwiera się w nowej karcie).
Blokada bota treningowego trzyma strony z dala od przyszłych modeli. Blokada bota wyszukiwarki albo bota pobierającego usuwa je z odpowiedzi i z linków w tych odpowiedziach.
Dwa z „botów” treningowych niczego nie pobierają. Google-Extended i Applebot-Extended to tylko tokeny: stronę ściąga Googlebot (otwiera się w nowej karcie) albo Applebot, a token mówi Google'owi i Apple, czy wolno na niej trenować. Ich blokada zostawia stronę w wyszukiwarkach Google i Apple, a blokada Google-Extended nie wyłącza też AI Overviews (otwiera się w nowej karcie): te słuchają reguł dla Googlebota. Drugi wyjątek to boty pobierające. OpenAI, Perplexity i Meta piszą, że ich boty mogą w ogóle nie stosować się do robots.txt, bo o stronę poprosił człowiek; Anthropic deklaruje, że Claude-User się stosuje.
Polska blokuje tak często jak świat, ale nie te same boty
Licząc wszystkie boty AI, różnica między próbą .pl a światową wynosi 2,2 punktu procentowego, dobrze w granicach błędu. Po podziale według przeznaczenia obraz się zmienia. Boty treningowe są blokowane równie często. Boty wyszukiwarek AI i boty pobierające na prośbę użytkownika – w Polsce ponad dwa razy rzadziej.
Polska blokuje trening tak często jak świat, wyszukiwarki AI dużo rzadziej
Odsetek stron, których robots.txt blokuje stronę główną co najmniej jednemu botowi danego rodzaju · n = 1000 w każdej próbie · 23 września 2026
- Top 1000 .pl
- Globalny top 1000
Pokaż dane
| Pozycja | Top 1000 .pl | Globalny top 1000 |
|---|---|---|
| Dowolny bot AI | 21% | 23% |
| Boty treningowe | 21% | 22% |
| Boty wyszukiwarek AI | 5,4% | 14% |
| Pobieranie na prośbę użytkownika | 5,3% | 13% |
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
GPTBot czy OAI-SearchBot: dwa osobne przełączniki
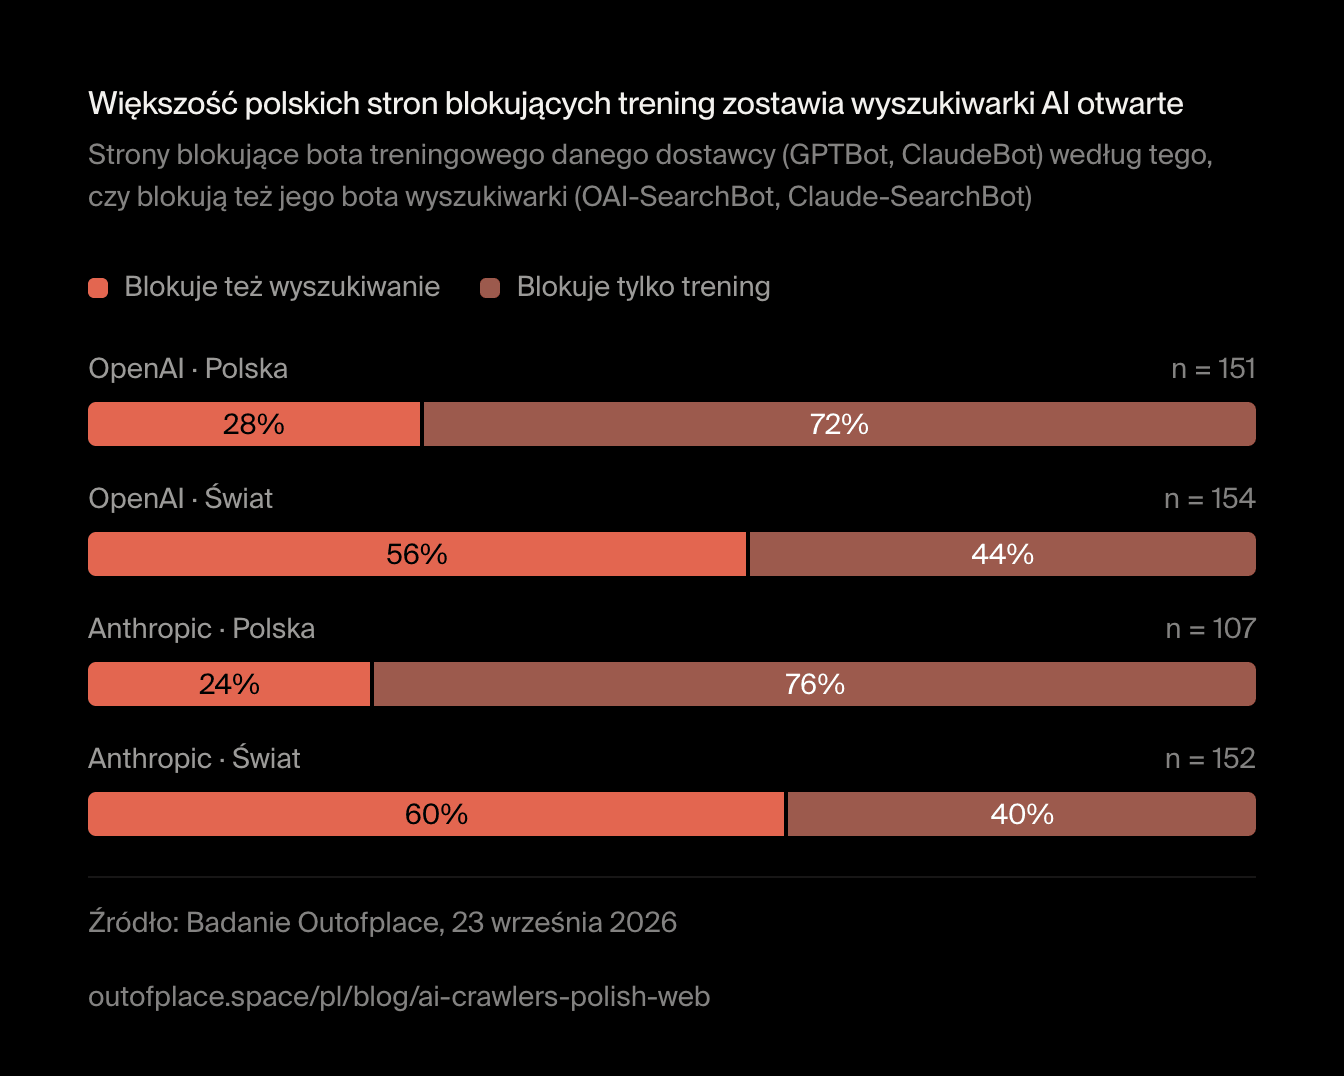
Najwyraźniej widać to u poszczególnych dostawców. Spośród polskich stron blokujących GPTBota OAI-SearchBota blokuje też 28%. W próbie światowej – 56%. U Anthropic różnica jest jeszcze większa: 24% wobec 60%.
Większość polskich stron blokujących trening zostawia wyszukiwarki AI otwarte
Strony blokujące bota treningowego danego dostawcy (GPTBot, ClaudeBot) według tego, czy blokują też jego bota wyszukiwarki (OAI-SearchBot, Claude-SearchBot)
- Blokuje też wyszukiwanie
- Blokuje tylko trening
Pokaż dane
| Pozycja | Blokuje też wyszukiwanie | Blokuje tylko trening | n |
|---|---|---|---|
| OpenAI · Polska | 28% | 72% | 151 |
| OpenAI · Świat | 56% | 44% | 154 |
| Anthropic · Polska | 24% | 76% | 107 |
| Anthropic · Świat | 60% | 40% | 152 |
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Na świecie strona, która blokuje boty AI, zwykle blokuje też te wyszukujące. W Polsce typowa strona wymienia kilka botów treningowych i na tym kończy: 11,2% polskiej próby blokuje wyłącznie trening, prawie dwa razy więcej niż 5,9% na świecie.
Które boty AI są blokowane najczęściej
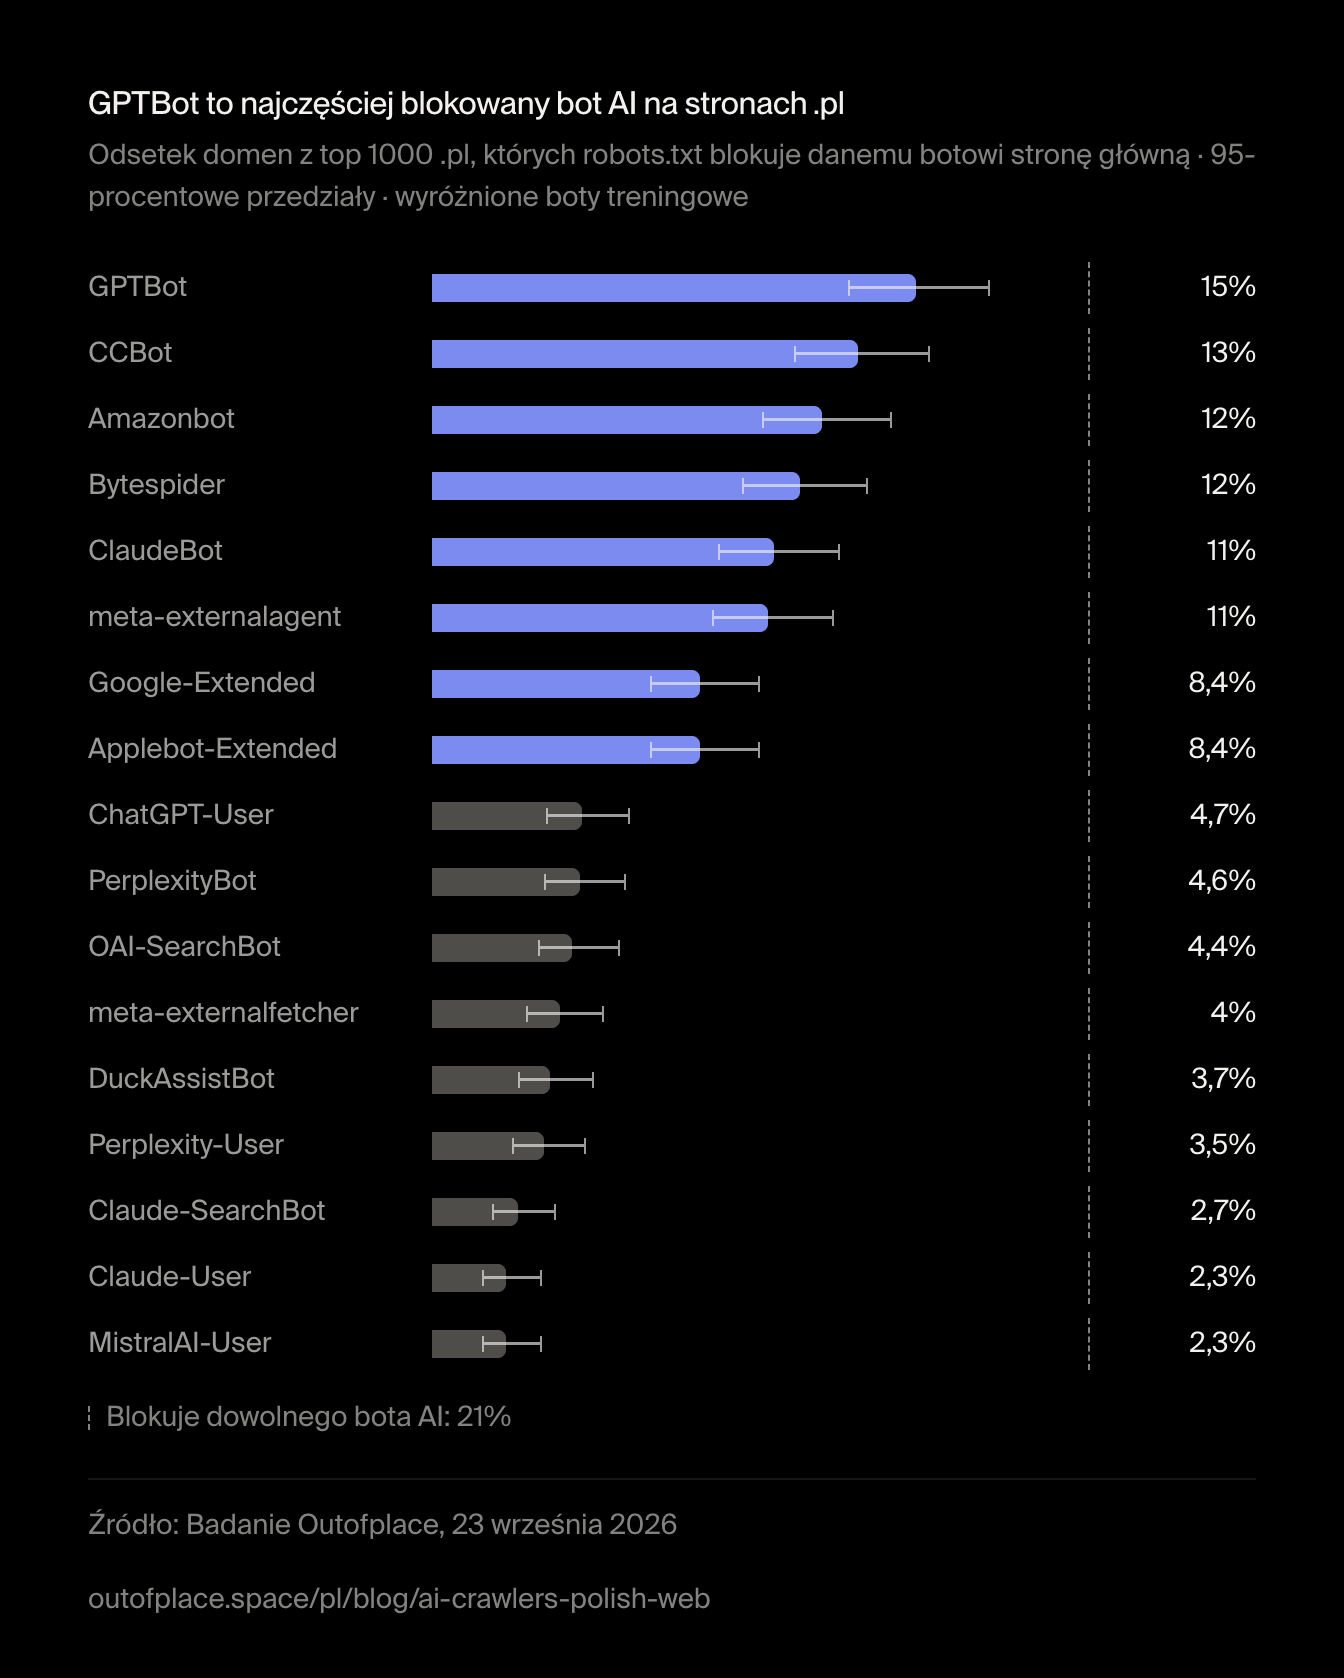
Prowadzi GPTBot: 15,1% polskich stron i 15,4% na świecie. OpenAI ogłosiło go w sierpniu 2023 i od niego zaczyna się większość list blokad. Dalej są CCBot z Common Crawl, Amazonbot, Bytespider od ByteDance i ClaudeBot. Najnowsze boty są ledwo widoczne: Claude-SearchBota blokuje 2,7% polskich stron, głównie dlatego, że listy powstały, zanim się pojawił.
GPTBot to najczęściej blokowany bot AI na stronach .pl
Odsetek domen z top 1000 .pl, których robots.txt blokuje danemu botowi stronę główną · 95-procentowe przedziały · wyróżnione boty treningowe
Blokuje dowolnego bota AI: 21%
Pokaż dane
| Pozycja | Wartość | Przedział 95% | n |
|---|---|---|---|
| GPTBot | 15% | 13%–17% | 1000 |
| CCBot | 13% | 11%–16% | 1000 |
| Amazonbot | 12% | 10%–14% | 1000 |
| Bytespider | 12% | 9,7%–14% | 1000 |
| ClaudeBot | 11% | 8,9%–13% | 1000 |
| meta-externalagent | 11% | 8,8%–13% | 1000 |
| Google-Extended | 8,4% | 6,8%–10% | 1000 |
| Applebot-Extended | 8,4% | 6,8%–10% | 1000 |
| ChatGPT-User | 4,7% | 3,6%–6,2% | 1000 |
| PerplexityBot | 4,6% | 3,5%–6,1% | 1000 |
| OAI-SearchBot | 4,4% | 3,3%–5,9% | 1000 |
| meta-externalfetcher | 4% | 3%–5,4% | 1000 |
| DuckAssistBot | 3,7% | 2,7%–5,1% | 1000 |
| Perplexity-User | 3,5% | 2,5%–4,8% | 1000 |
| Claude-SearchBot | 2,7% | 1,9%–3,9% | 1000 |
| Claude-User | 2,3% | 1,5%–3,4% | 1000 |
| MistralAI-User | 2,3% | 1,5%–3,4% | 1000 |
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Prawie wszystko to świadome decyzje. Strona, która w grupie User-agent: * zabrania wszystkiego, blokuje każdego bota bez własnej grupy, AI czy nie. Ta „podłoga” odpowiada w przypadku GPTBota tylko za 1,9% polskich stron; reszta wymienia bota z nazwy.
Poniżej polski i światowy odsetek dla każdego bota obok siebie. Obie próby zgadzają się co do botów treningowych. Rozchodzą się przy wszystkim, co służy odpowiedziom.
Różnica pojawia się przy wyszukiwarkach i botach pobierających
Odsetek stron blokujących danemu botowi stronę główną · top 1000 .pl wobec światowego top 1000
- Top 1000 .pl
- Globalny top 1000
Pokaż dane
| Pozycja | Top 1000 .pl | Globalny top 1000 |
|---|---|---|
| GPTBot | 15% | 15% |
| CCBot | 13% | 18% |
| Amazonbot | 12% | 13% |
| Bytespider | 12% | 17% |
| ClaudeBot | 11% | 15% |
| meta-externalagent | 11% | 14% |
| Google-Extended | 8,4% | 14% |
| Applebot-Extended | 8,4% | 13% |
| ChatGPT-User | 4,7% | 11% |
| PerplexityBot | 4,6% | 13% |
| OAI-SearchBot | 4,4% | 8,9% |
| meta-externalfetcher | 4% | 9,9% |
| DuckAssistBot | 3,7% | 9,5% |
| Perplexity-User | 3,5% | 10% |
| Claude-SearchBot | 2,7% | 9,2% |
| Claude-User | 2,3% | 9,5% |
| MistralAI-User | 2,3% | 9,6% |
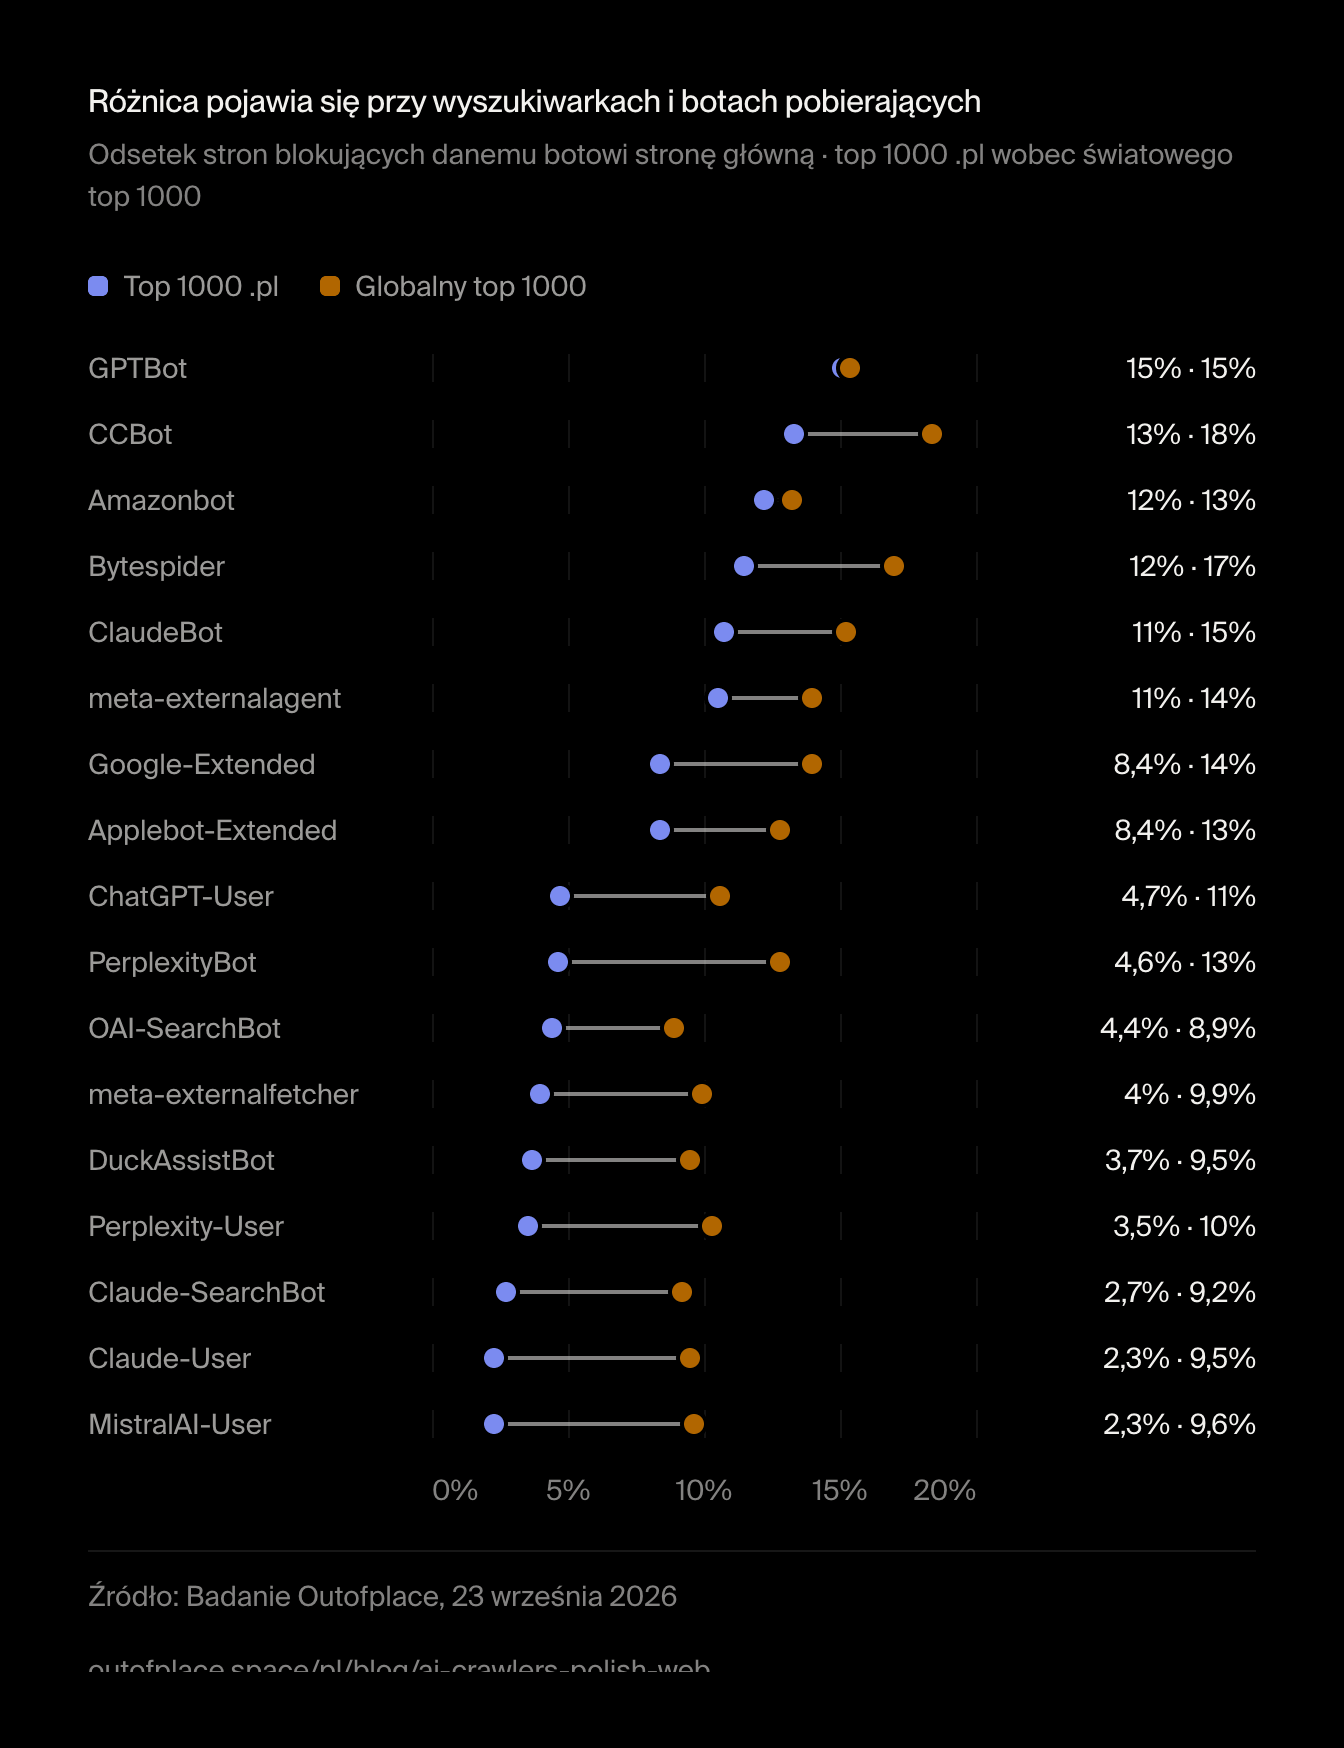
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Większe strony blokują częściej
Im popularniejsza strona, tym częściej blokuje. Co najmniej jednego bota AI blokuje 33% ze stu najpopularniejszych domen .pl i 15,8% z miejsc od 501 do 1000. Spadek jest bardziej stromy niż w próbie światowej, gdzie wynosi od 27% do 21,2%. Największe polskie strony to wydawcy, marketplace'y i portale: firmy, które mają najwięcej tekstu do ochrony i prawników, którzy zadają to pytanie.
Jedna trzecia stron z top 100 .pl blokuje boty AI
Odsetek blokujących co najmniej jednego bota AI według miejsca w próbie · n = 100, 400 i 500
- Top 1000 .pl
- Globalny top 1000
Pokaż dane
| Pozycja | Top 1000 .pl | Globalny top 1000 |
|---|---|---|
| Top 100 | 33% | 27% |
| 101–500 | 23% | 24% |
| 501–1000 | 16% | 21% |
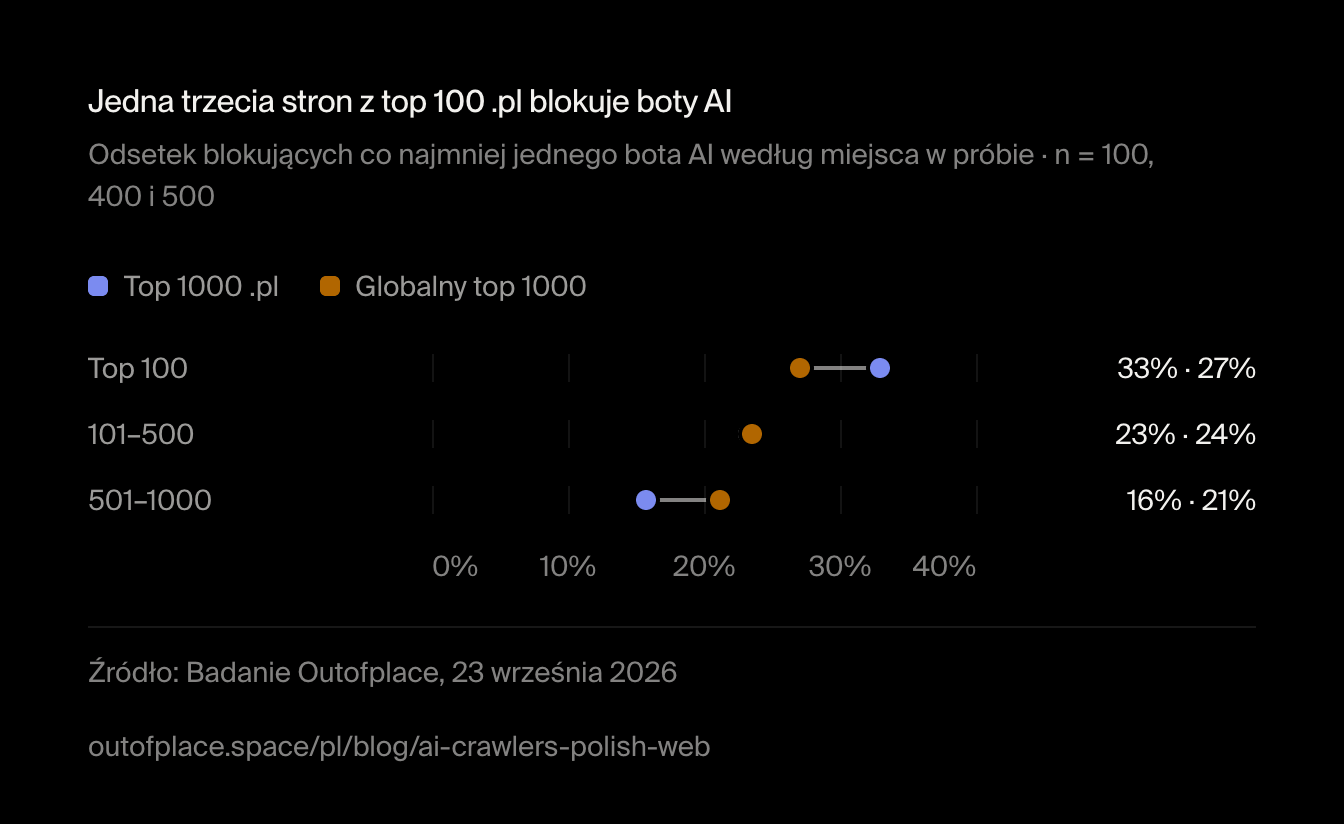
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Efekt wielkości widać przy każdym bocie z osobna. GPTBota blokuje 23% stron z top 100 i 11,6% stron z miejsc od 501 do 1000; każdy bot treningowy idzie tym samym spadkiem. Boty wyszukiwarek zostają nisko przy każdej wielkości.
Największe strony .pl najczęściej blokują boty treningowe, a wyszukiwarki rzadko niezależnie od wielkości
Odsetek stron .pl blokujących danemu botowi stronę główną według miejsca w próbie · n = 100, 400 i 500
| Pozycja | Top 100 | 101–500 | 501–1000 |
|---|---|---|---|
| GPTBot | 23% | 18% | 12% |
| CCBot | 21% | 16% | 9,6% |
| Amazonbot | 16% | 16% | 8,8% |
| Bytespider | 19% | 14% | 8% |
| ClaudeBot | 14% | 13% | 8,6% |
| meta-externalagent | 15% | 14% | 6,8% |
| Google-Extended | 12% | 11% | 5,8% |
| Applebot-Extended | 11% | 11% | 5,6% |
| OAI-SearchBot | 7% | 4,3% | 4% |
| PerplexityBot | 6% | 4,8% | 4,2% |
| Claude-SearchBot | 4% | 2,3% | 2,8% |
Pokaż jako obraz
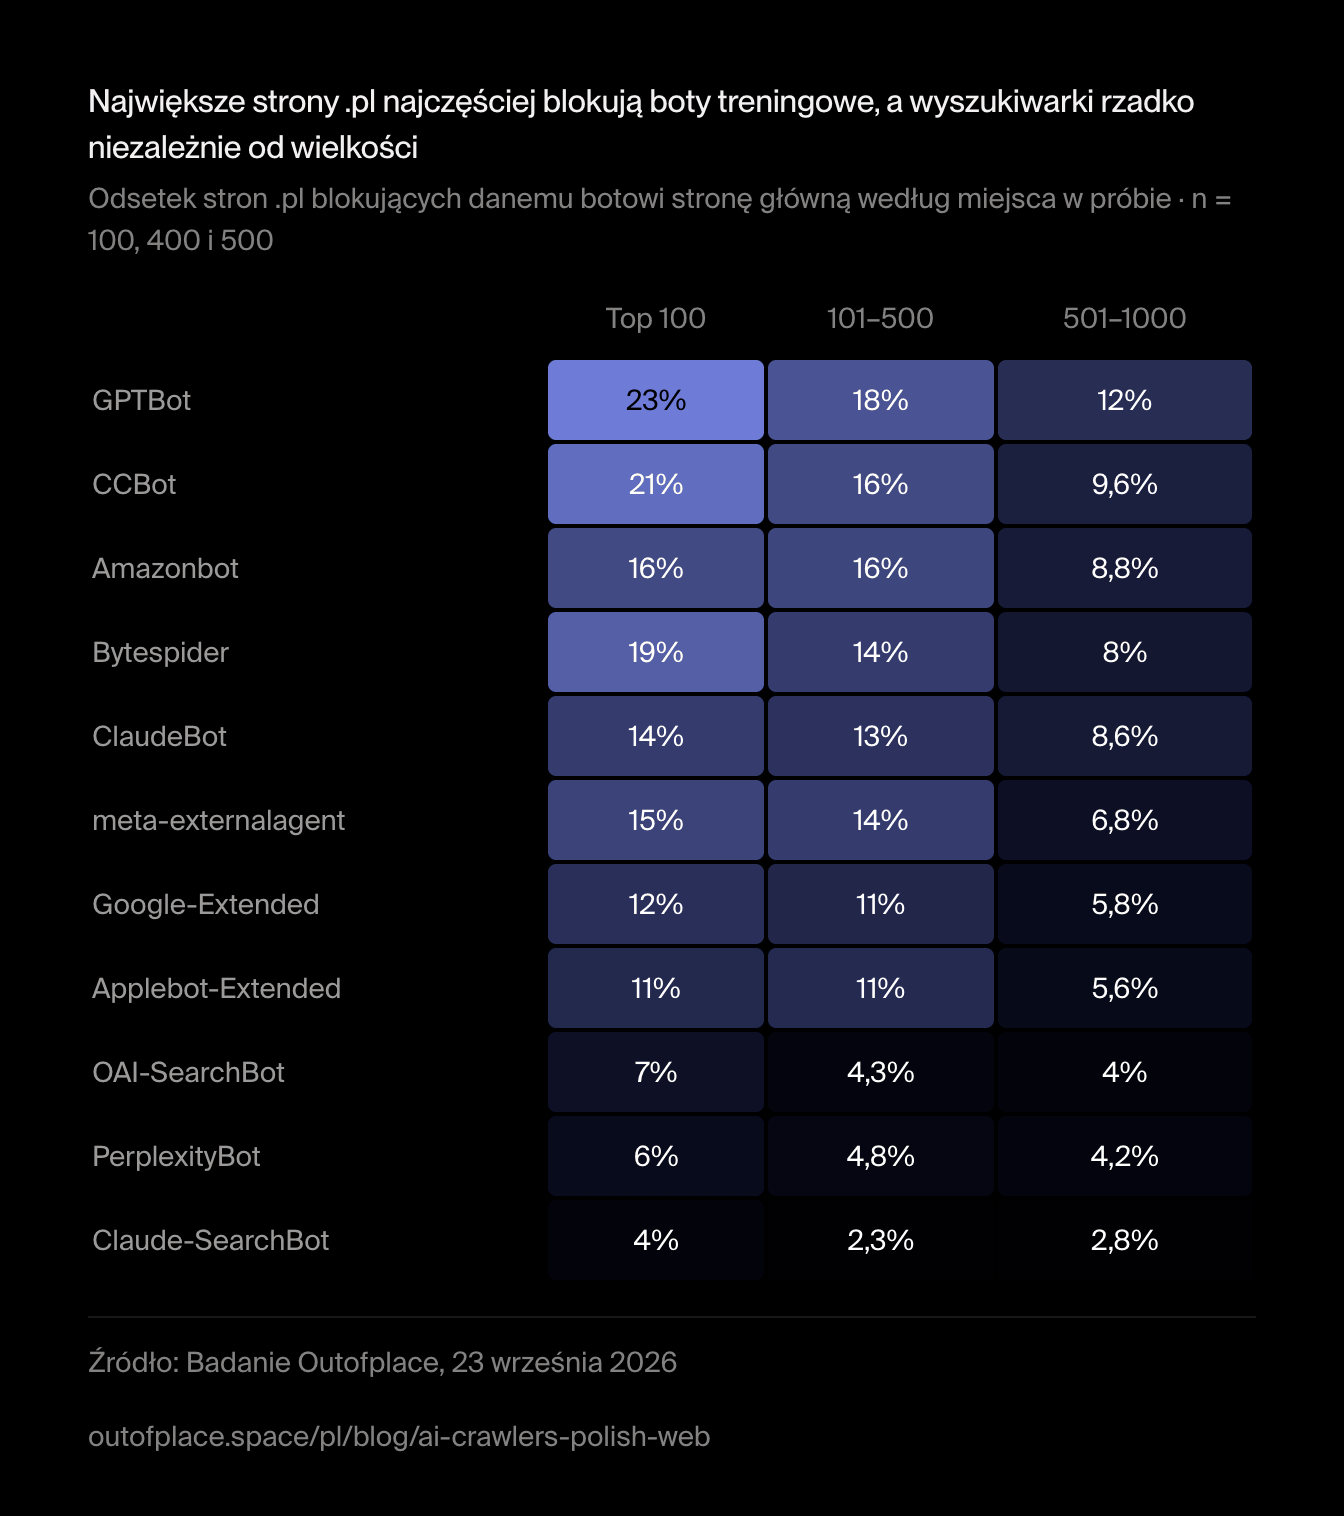
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Instytucje publiczne blokują rzadziej i nie celowo. Bota AI blokuje 11,9% spośród 42 domen gov.pl w próbie i 16,1% spośród 31 domen edu.pl; obie grupy są małe, więc traktuj to jako kierunek. Większość tych blokad to w ogóle nie polityka wobec AI. sejm.gov.pl, dziennikustaw.gov.pl i wroclaw.sa.gov.pl wpuszczają Googlebota i zabraniają wszystkim innym (otwiera się w nowej karcie), co odcina każdego bota AI, a razem z nimi Binga i DuckDuckGo. W przypadku Sejmu i Dziennika Ustaw oznacza to też, że Copilot i wyszukiwarka ChatGPT nie przeczytają źródeł, o które ludzie ich pytają.
Listy się starzeją
Listy blokad pisze się raz i kopiuje latami. 7,2% polskich stron wciąż blokuje anthropic-ai, nazwę, której Anthropic przestał używać (dokumentacja wymienia dziś ClaudeBota, Claude-SearchBota i Claude-User), a Claude-SearchBota tylko 2,7%. W 4,1% próby lista jest nieaktualna w sposób, który ma znaczenie: blokuje starą nazwę, a bota, który ją zastąpił, przepuszcza.
Trzeba oddać Anthropic, że powiedział 404 Media w 2024 roku (otwiera się w nowej karcie), iż ClaudeBot respektuje reguły zapisane dla dwóch wycofanych nazw. To dobra wola, nie standard: według RFC 9309 (otwiera się w nowej karcie) reguła dla anthropic-ai ClaudeBota nie dotyczy, a następny dostawca, który zmieni nazwę bota, może nie być tak hojny.
Zarządzany robots.txt od Cloudflare i Content Signals
3,1% polskich stron serwuje zarządzany robots.txt od Cloudflare (otwiera się w nowej karcie): jeden przełącznik w panelu i CDN dokleja przed plikiem strony blok reguł, który sam aktualizuje. Blok zabrania dostępu dokładnie ośmiu botom treningowym z naszej listy, od GPTBota po Amazonbota, i żadnemu botowi wyszukiwarki. Te strony, w tym regionalne tytuły Polska Press, takie jak poranny.pl, nto.pl, pomorska.pl i gazetawroclawska.pl, to 15,1% wszystkich polskich stron blokujących boty AI i 24% stron blokujących tylko trening. Częściowo tłumaczą, czemu Polska skłania się w tę stronę, ale nie w całości: bez nich blokowanie samego treningu i tak jest częstsze niż w próbie światowej, gdzie zarządzanego pliku nie znaleźliśmy wcale. Duże międzynarodowe serwisy piszą własne.
Ten przełącznik widać w liczbach. Za Cloudflare boty AI blokuje 25,6% polskich stron, a poza nim 18,2%. Na świecie jest odwrotnie.
W Polsce strony za Cloudflare blokują częściej
Odsetek blokujących co najmniej jednego bota AI według tego, czy strona idzie przez Cloudflare
- Za Cloudflare
- Inny hosting
Pokaż dane
| Pozycja | Za Cloudflare | Inny hosting |
|---|---|---|
| Polska | 26% | 18% |
| Świat | 19% | 24% |
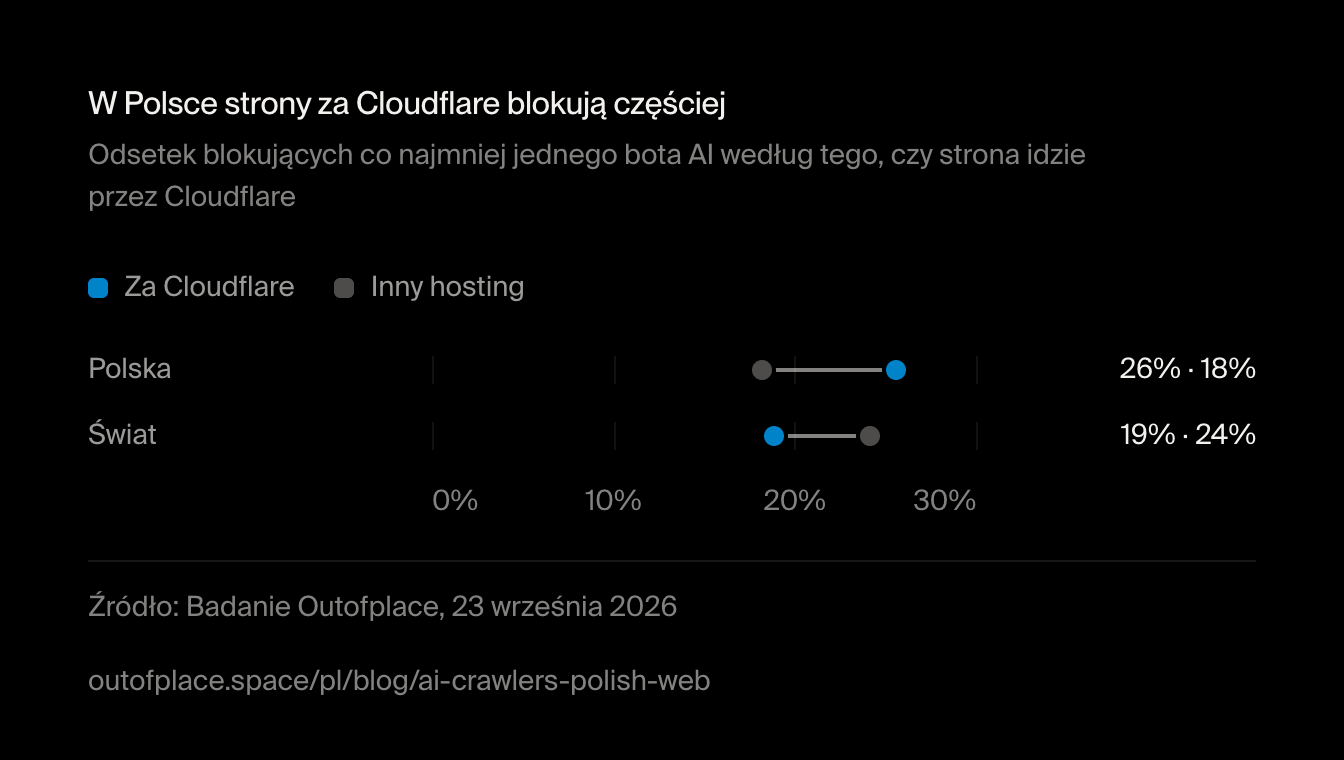
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Zarządzany plik zawiera też linię Content-Signal (search=yes, ai-train=no), część Content Signals Policy (otwiera się w nowej karcie), którą Cloudflare opublikował we wrześniu 2025, by deklarować, do czego wolno używać treści: wyszukiwanie, dane wejściowe dla AI, trening AI. W ten sposób ai-train=no deklaruje 3,9% polskich stron i 1,6% na świecie. Jeśli tester robots.txt oznacza Content-Signal jako nieznaną dyrektywę, to normalne i nieszkodliwe: według RFC 9309 bot pomija linie, których nie rozumie. 79% tych linii pochodzi z zarządzanego pliku, a nie od kogoś, kto je wpisał.
Co to jest llms.txt i kto go ma?
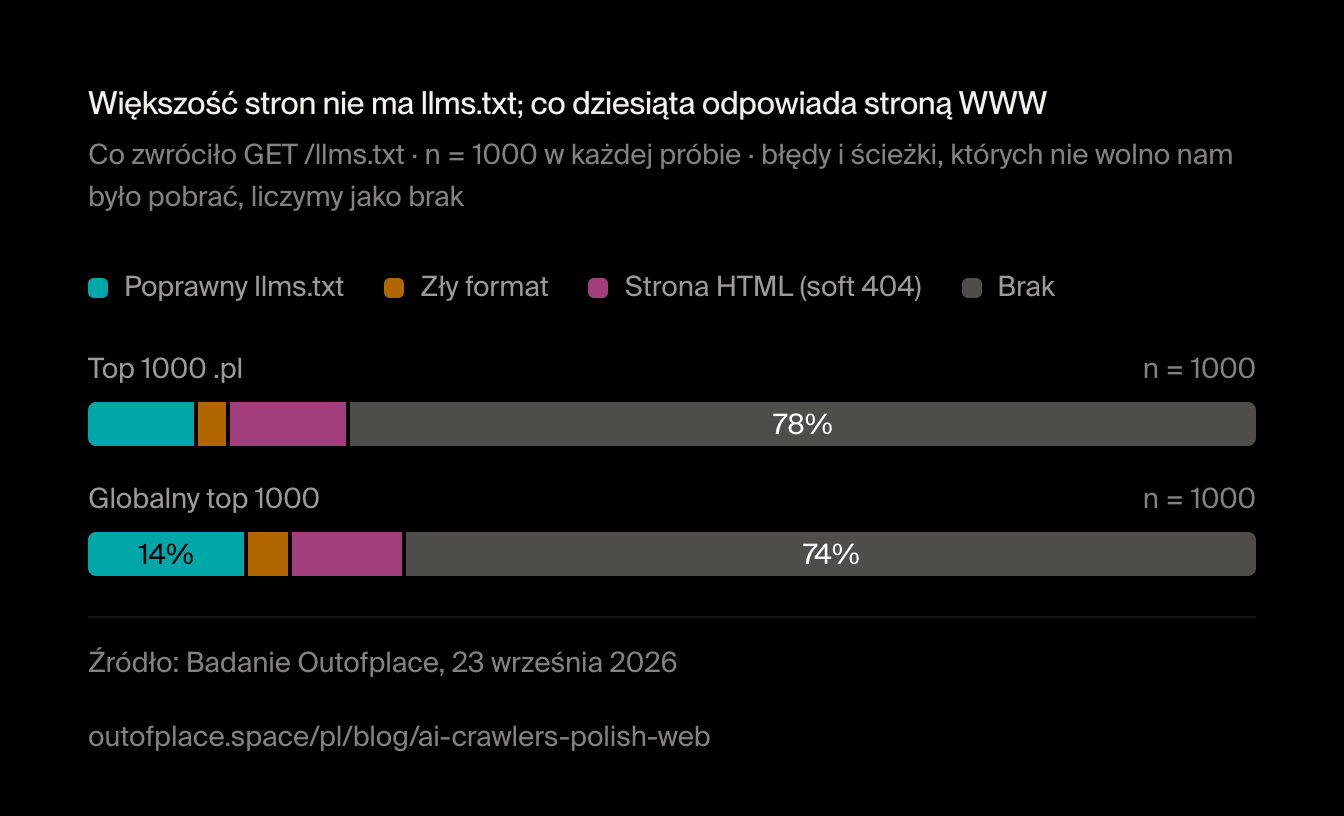
llms.txt (otwiera się w nowej karcie) to plik Markdown, który mówi modelom językowym, czym jest serwis i gdzie są najważniejsze strony; zaproponował go Jeremy Howard (otwiera się w nowej karcie) we wrześniu 2024. Specyfikacja wymaga tylko nagłówka H1 z nazwą serwisu; my wymagaliśmy też co najmniej jednego linku, bo plik bez linków nigdzie nie prowadzi. Taki plik pod /llms.txt serwuje 9,2% polskiej próby. Kolejne 10% odpowiada pod /llms.txt stroną HTML ze statusem 200 i to właśnie dostaje model, który próbuje go przeczytać, a niedbały checker liczy jako „ma llms.txt”.
Pierwsze były firmy hostingowe: home.pl, nazwa.pl, cyberfolks.pl, dhosting.pl i kei.pl serwują poprawny plik, podobnie mbank.pl, t-mobile.pl, rossmann.pl, mediamarkt.pl, a z instytucji publicznych uokik.gov.pl. Google pisze, że jego wyszukiwarka ten plik ignoruje (otwiera się w nowej karcie); jest dla innych asystentów. Sami też go udostępniamy: nasz llms.txt wymienia nasze badania, case studies i usługi, a llms-full.txt zawiera pełny tekst każdego wpisu.
Większość stron nie ma llms.txt; co dziesiąta odpowiada stroną WWW
Co zwróciło GET /llms.txt · n = 1000 w każdej próbie · błędy i ścieżki, których nie wolno nam było pobrać, liczymy jako brak
- Poprawny llms.txt
- Zły format
- Strona HTML (soft 404)
- Brak
Pokaż dane
| Pozycja | Poprawny llms.txt | Zły format | Strona HTML (soft 404) | Brak | n |
|---|---|---|---|---|---|
| Top 1000 .pl | 9,2% | 2,4% | 10% | 78% | 1000 |
| Globalny top 1000 | 14% | 3,4% | 9,6% | 74% | 1000 |
Wykres jako obraz. Możesz go użyć na licencji CC BY 4.0, podając Outofplace jako źródło i link do tej strony.
Reszta sieci czytelnej dla maszyn
Boty czytają więcej niż robots.txt. Polskie strony są tu blisko świata w podstawach i odstają w szczegółach, które pomagają maszynie umiejscowić stronę: alternatywach hreflang (otwiera się w nowej karcie) i mapie strony wskazanej tam, gdzie boty jej szukają (otwiera się w nowej karcie). Kompresja Zstandard (otwiera się w nowej karcie) jest na stronach głównych .pl kilka razy częstsza, ale to znowu Cloudflare: wszystkie polskie strony, które ją wysłały, poza jedną, szły przez ten CDN.
| Sygnał | Polska | Świat |
|---|---|---|
| <html lang> | 89% | 89% |
| Tagi Open Graph | 71% | 70% |
| JSON-LD | 49% | 47% |
| Sitemap w robots.txt | 53% | 62% |
| hreflang | 18% | 35% |
| HTTP/2 | 82% | 89% |
| Ogłoszone HTTP/3 | 30% | 36% |
| Brotli | 31% | 32% |
| Zstandard | 8,3% | 2,4% |
Trzy polityki warte skopiowania
Niektóre polskie strony wyraźnie to przemyślały. Każdy z tych plików sprawdziliśmy ręcznie w dniu badania.
- Trening nie, odpowiedzi tak. Tytuły Wirtualnej Polski (wp.pl, o2.pl, money.pl, pudelek.pl, abczdrowie.pl, dobreprogramy.pl) zabraniają dostępu GPTBotowi, CCBotowi i Bytespiderowi (otwiera się w nowej karcie), a OAI-SearchBotowi, ChatGPT-User, PerplexityBotowi i Perplexity-User dają własne grupy
Allow: /. Wydawca, który mówi dokładnie, czego chce. - Wszyscy mile widziani, z imienia. mediamarkt.pl i euro.com.pl mają grupy
Allow: /(otwiera się w nowej karcie) dla GPTBota, ClaudeBota, OAI-SearchBota, Claude-SearchBota, PerplexityBota i innych. Dla sprzedawcy asystent polecający produkt to witryna sklepowa. - Niech listę prowadzi CDN. Regionalne tytuły Polska Press używają zarządzanego pliku Cloudflare, który blokuje boty treningowe i pozostaje aktualny bez niczyjej edycji.
Jak zablokować ChatGPT i inne boty AI w robots.txt
Czy blokować boty AI?
Nie ma jednej dobrej polityki. Wydawca, który sprzedaje archiwum, ma inne interesy niż sklep, który chce być polecany. Ale cokolwiek wybierzesz, wybieraj według przeznaczenia bota, nie według dostawcy:
Blokada wszystkich botów AI
- Poza przyszłymi modelami
- Poza odpowiedziami ChatGPT, Claude'a i Perplexity
- Brak linków z odpowiedzi AI
- Listę trzeba ciągle aktualizować
Blokada tylko treningu
- Poza przyszłymi modelami
- Cytowani i linkowani w odpowiedziach AI
- Kto pyta asystenta, wciąż cię znajdzie
- Boty wyszukiwarek zmieniają się rzadziej
robots.txt, który blokuje trening i zostawia wyszukiwarki AI
Tak wygląda robots.txt, który blokuje trening i zostawia wyszukiwarki AI. Grupa treningowa to te same osiem botów, które blokuje zarządzany plik Cloudflare. Nasza strona robi odwrotnie i wpuszcza wszystkie boty, bo blog studia jest po to, żeby go cytowano.
# Wyszukiwarki AI i pobieranie na prośbę użytkownika: cytują i linkują
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
Allow: /
# Nazwane grupy nie dziedziczą z *, więc powtórz prywatne ścieżki
Disallow: /koszyk/
Disallow: /konto/

# Trenowanie modeli
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
User-agent: Bytespider
User-agent: meta-externalagent
User-agent: Amazonbot
Disallow: /

# Wszyscy pozostali, w tym Googlebot i Bingbot
User-agent: *
Disallow: /koszyk/
Disallow: /konto/

Sitemap: https://www.example.pl/sitemap.xml
Zdecyduj według przeznaczenia
Trening, wyszukiwarki AI, pobieranie na prośbę użytkownika. Zapisz, czego chcesz dla każdego, zanim dotkniesz pliku.
Wpisz aktualne nazwy
Bierz je ze stron dostawców, nie z listy, którą ktoś wrzucił w 2023.
Powtórz prywatne ścieżki w każdej nazwanej grupie
Bot, który pasuje do nazwanej grupy, całkowicie ignoruje
User-agent: *.Przetestuj
Wklej plik do narzędzia poniżej i sprawdź ścieżki, które są dla ciebie ważne.
Pokryj to, czego robots.txt nie obejmie
Copilot jeździ na Bingbocie, więc steruje się nim meta tagami
noarchiveinocache(otwiera się w nowej karcie). AI Overviews w Google słuchają Googlebota i ustawień fragmentów, np.nosnippet(otwiera się w nowej karcie). Boty pobierające, które mogą ignorować robots.txt, zatrzyma dopiero reguła w CDN albo na serwerze.Sprawdzaj co kwartał
Nowe boty pojawiają się kilka razy w roku. Nieaktualna lista jest gorsza niż żadna, bo wygląda jak decyzja.
Wklej tu swój robots.txt, żeby zobaczyć, co może pobrać każdy bot AI. Działa w przeglądarce, na tym samym parserze, którego użyliśmy w badaniu; nic nie jest nigdzie wysyłane.
Narzędzie
Które crawlery AI mogą czytać Twoją stronę?
Wklej swój robots.txt. Sprawdzamy go tutaj, w Twojej przeglądarce, tym samym parserem RFC 9309 i tą samą listą botów co w naszym badaniu; nic z tego, co wkleisz, nigdzie nie wychodzi.
Jak mierzyliśmy
Które strony się liczą i dlaczego 1000
Próba to pierwsze 1000 domen .pl z listy Tranco, które odpowiedziały na nasze zapytania. 23 z nich zabrania naszemu botowi dostępu do strony głównej w robots.txt; ich robots.txt i tak przeczytaliśmy (z definicji jest publiczny), ale nic więcej nie pobieraliśmy. Domeny z błędem DNS, odrzuconym połączeniem albo błędem serwera pomijaliśmy i braliśmy następną z listy. Przy 1000 stron 95-procentowy przedział dla głównego wyniku wynosi od 18,1% do 23,1%.
Jak klasyfikujemy politykę strony
Każda strona dostaje jedną klasę, wygrywa pierwsze dopasowanie. Blokada całkowita: zablokowany jest też Googlebot, więc reguła nie dotyczy AI. Wszystkie boty AI: zablokowane są wszystkie boty treningowe i co najmniej jeden bot wyszukiwarki lub pobierający. Nieaktualna lista: zablokowana jest nazwa, której dostawca już nie dokumentuje, a bot, który ją zastąpił, nie. Tylko trening: zablokowane boty treningowe, żaden bot wyszukiwarki ani pobierający. Niespójna: zablokowany bot wyszukiwarki lub pobierający, a przepuszczony bot treningowy. Otwarta: żaden bot AI nie jest zablokowany. Reguły i ich testy są w repozytorium.
Czego te dane nie mówią
robots.txt to tylko to, o co strona prosi. Część stron blokuje boty AI na firewallu lub w CDN, a część każdemu botowi pokazuje wyzwanie; wyzwania liczyliśmy osobno i nigdy jako „wpuszczone”. Sprawdzaliśmy tylko ścieżkę strony głównej: strona, która blokuje botom artykuły, ale nie /, liczy się jako otwarta. Domena .pl to nie to samo co polska firma, a listy popularności faworyzują duże serwisy. Liczby opisują najczęściej odwiedzaną część polskiego internetu w jednym dniu.
Czy blokować boty AI?
Decyduj według przeznaczenia. Zablokuj boty treningowe (GPTBot, ClaudeBot, Google-Extended, CCBot i inne), jeśli nie chcesz, żeby twoje strony trafiały do przyszłych modeli. Zostaw boty wyszukiwarek AI (OAI-SearchBot, Claude-SearchBot, PerplexityBot), jeśli chcesz być cytowany i linkowany w odpowiedziach ChatGPT, Claude'a i Perplexity: ich blokada usuwa cię z tych odpowiedzi.
Jak zablokować ChatGPT w robots.txt?
ChatGPT ma trzy boty. GPTBot zbiera dane do trenowania modeli, OAI-SearchBot indeksuje strony dla wyszukiwarki ChatGPT, a ChatGPT-User otwiera strony na prośbę użytkownika. OpenAI traktuje je niezależnie: blokada GPTBota nie usuwa strony z wyszukiwarki ChatGPT, robi to dopiero blokada OAI-SearchBota. OpenAI zaznacza też, że reguły robots.txt mogą nie dotyczyć ChatGPT-User.
Czy blokada Google-Extended wyłącza AI w Google albo obniża pozycje?
Ani jedno, ani drugie. Google pisze, że Google-Extended nie wpływa na obecność ani pozycję w wyszukiwarce Google; decyduje o tym, czy treści służą do trenowania modeli Gemini i ugruntowywania ich odpowiedzi. AI Overviews i tryb AI są częścią wyszukiwarki i słuchają reguł dla Googlebota oraz ustawień fragmentów, takich jak nosnippet.
Jak wyłączyć stronę z Microsoft Copilot?
Microsoft nie ma osobnego bota AI: Bing i Copilot korzystają z tego samego crawla Bingbota. Zamiast tego Microsoft opisuje dwa meta tagi: noarchive wyłącza stronę z odpowiedzi Copilota i z trenowania, a nocache ogranicza Copilota do adresu, tytułu i fragmentu. Oba zostawiają stronę w wyszukiwarce Bing.
Ile polskich stron blokuje boty AI?
W naszym badaniu z września 2026 20,5% z 1000 najpopularniejszych domen .pl blokowało w robots.txt co najmniej jednego bota AI (95-procentowy przedział 18,1%–23,1%). Najczęściej blokowany był GPTBot: 15,1%.
Czy potrzebuję llms.txt?
Nie, ale to tani i nieszkodliwy plik: Markdown, zwykle pod /llms.txt, który mówi modelom językowym, czym jest serwis, i linkuje do najważniejszych stron. Google pisze, że jego wyszukiwarka go ignoruje, a żadna z dużych firm AI nie ogłosiła, że używa go przy rankingu, więc traktuj go jako uprzejmość, nie dźwignię. Poprawny ma tylko 9,2% największych stron .pl.
Czy boty AI respektują robots.txt?
Zatrzymuje te, które chcą go przestrzegać. Duzi dostawcy deklarują, że ich boty treningowe i wyszukujące stosują się do robots.txt, ale OpenAI, Perplexity i Meta piszą, że ich boty pobierające na prośbę użytkownika mogą tego nie robić, bo o stronę poprosił człowiek. robots.txt to prośba, a nie kontrola dostępu; do egzekwowania potrzebne są reguły na serwerze albo w CDN.